方法文章 · 作者:林奥杰 · 原站发布:2026-10-02
本文为林奥杰署名的方法文章,涉及作者的Alaya知识中枢设计与实践。
文/林奥杰
你可能已经和 AI 聊过几百次。
让它帮你读报告、改文章、想方案、做课程。某个深夜,它给出的一个解释,甚至让你觉得:终于有人把这件事讲明白了。
但一个月后,你还能找到那段对话吗?
找到以后,它还能接上你后来读过的资料、改过的方案,以及最终作出的决定吗?
我们正在经历一种奇怪的浪费:获取答案越来越容易,积累自己的理解却没有同样变得容易。
每天生成很多内容,到了下一次工作,还是要重新介绍背景、重新上传文件、重新解释”我究竟想做什么”。
AI 很忙,我们也很忙,知识却没有留下来。
AI 时代,每个人都该有一个自己的数字大脑。它要保存的,不只是资料,还有你与资料之间逐渐形成的理解。
一、收藏了很多,不等于拥有了知识
我们的电脑里,大概都有几个这样的文件夹:
“学习资料”。
“重要报告”。
“以后看”。
还有一个最诚实的名字:“新建文件夹”。
里面的内容可能非常有价值。论文、政策、采访、课程、项目方案,甚至还有自己几年前写下的好想法。
可一旦要用,就开始找。
搜文件名,翻聊天记录,问同事,最后又让 AI 从头解释一遍。
问题在于,一篇报告被下载下来,只意味着你拥有了一个文件。它与哪个问题有关,支持了什么判断,又与另一篇报告存在什么矛盾,往往没有被记录。
文件越来越多,关系却没有建立起来。
资料的数量在增加,调用资料的成本也在增加。
数字大脑要解决的,就是这一步:让收藏过的东西,逐渐成为可以找到、可以理解、可以连接、可以使用的知识。
二、让 AI 从回答问题,走向维护知识
2026 年 4 月,Andrej Karpathy 提出了 LLM Wiki 的知识库构建思路,并于 4 月 4 日发布原始说明。Karpathy 曾是 OpenAI 创始成员、特斯拉 AI 总监。
这个思路的关键,是让大模型参与维护一个持续存在的知识库。
可以把它理解为:让 AI 充当**“知识编译器”**。
你提供一篇新文章,它读完以后,提取重要信息,补充已有条目,连接相关概念,并标记新旧材料之间的分歧。
下一次提问,这些整理过的知识就可以继续使用。新资料进入,知识库再继续更新。
这和常见的”上传文件,然后问问题”有所区别。
在典型的 RAG(检索增强生成)流程中,系统根据当前问题找出相关资料片段,再组织回答。LLM Wiki 则把一部分整理和综合工作提前做了,并将结果保存下来。
检索依然有用。只是每次理解,不必都从零开始。
一场对话结束以后,应该有一些东西留下来。
留下来的可以是一个概念的解释、一组相互关联的案例、一份更新过的项目判断,也可以是一个尚未解决、但已经知道该去哪里寻找证据的问题。
三、数字大脑,应该能够记住你的工作过程
假设你正在准备一门关于文化数字资产的课程。
- 第一周,你收集了几份政策文件。
- 第二周,你找到几个博物馆、非遗项目和数字文创案例。
- 第三周,你发现其中一个案例只有宣传报道,无法确认实际运营情况。于是决定不用它,换成另一个能够追溯来源的案例。
- 第四周,课程准备继续。
如果这些信息散落在聊天和文件夹中,你可能又把那个已经放弃的案例捡回来,再走一遍旧路。
一个有用的数字大脑,应当保留:
- 这个案例来自哪里。
- 哪些情况已经核实。
- 哪些说法仍然存疑。
- 为什么暂时不采用。
- 最后选用了哪个案例,放进课程的哪一部分。
这样,AI 才有条件接续你的工作。
它既能找到材料,也能知道你已经走到哪里。
长期记忆的价值,在于保存那些会影响下一次行动的信息。
对于研究者,它可能是论证与证据之间的关系;对于教师,是课程修改的依据;对于经营者,是产品迭代和客户需求的变化;对于个人,是一次重要决定背后的理由。
四、一个数字大脑,可以从七层结构开始
在 AI奥杰的设计中,我把这套知识中枢称为 Alaya,阿赖耶识。
它的定位是:AI 协作的长期记忆、知识索引与生产中枢。
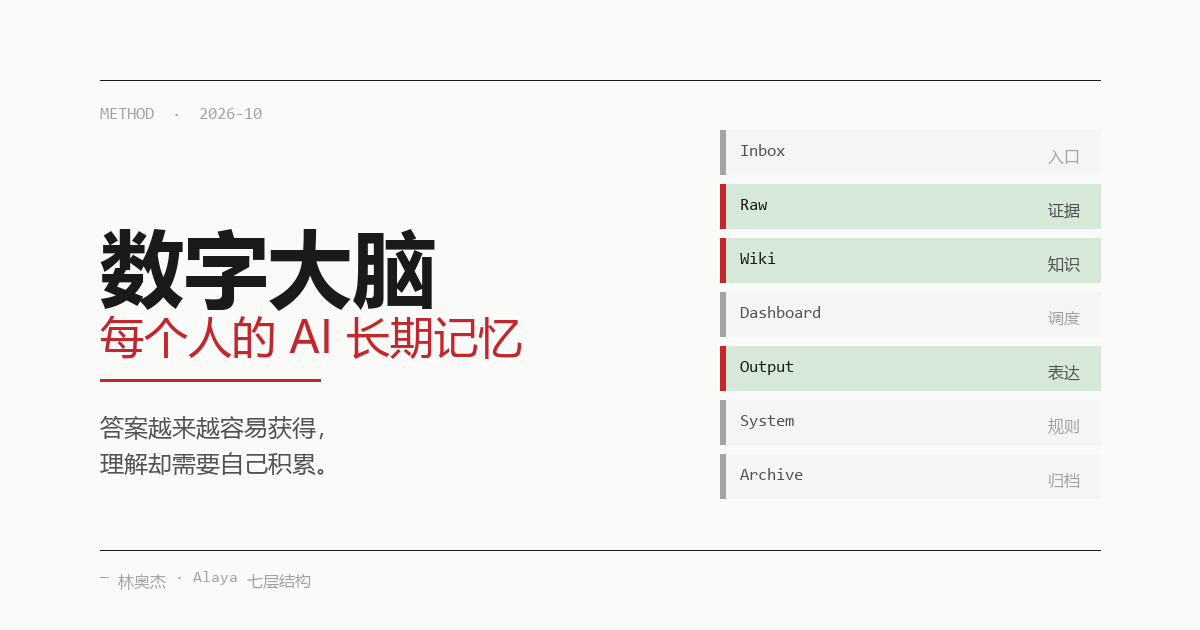
我们把它组织为七层:
| 层次 | 作用 |
|---|---|
| Inbox,入口层 | 接收新资料、临时想法和待处理事项 |
| Raw,证据层 | 保存原件与来源 |
| Wiki,知识层 | 提炼概念、案例、方法,并建立联系 |
| Dashboard,调度层 | 记录进度、缺口与下一步 |
| Output,表达层 | 保存文章、课程、报告等成果 |
| System,规则层 | 规定整理、检索和更新方法 |
| Archive,归档层 | 保留已完成、过时或暂停的内容 |
这七层是 Alaya 的具体实施设计,不是 LLM Wiki 唯一的目录标准。
它背后的逻辑很简单:
资料先进入,证据留下来,知识被整理,成果被生产,过程可以接续。
比如一份政策文件,原件保存在 Raw;适用范围和核心内容进入 Wiki;课程中的相关章节保存在 Output;尚未核实的问题进入 Dashboard。
它们之间通过链接连接。
以后政策调整了,你就有机会找到哪些知识条目和成果需要重新检查。
五、为什么选择 Obsidian?
搭建数字大脑,需要一个方便查看、编辑和连接知识的地方。
Obsidian 是很合适的工具。
它以本地 Markdown 文件为基础。Markdown 可以理解为一种结构清楚、便于阅读和编辑的文本格式。
你可以在 Obsidian 中阅读笔记、建立内部链接、查看反向链接,也可以通过关系图观察条目之间的联系。需要更复杂的工作方式时,还可以开发扩展和插件。
这让人与 AI 能够围绕同一批文件协作。
AI 整理知识,你打开文件查看结果;发现问题,直接修改;需要继续工作,再让 AI 读取相关内容。
文件承载知识,Obsidian 提供工作界面,AI 参与加工,Skill 规定怎么做。
这也是 AI奥杰本地知识层的基础。
不过,本地保存文件与模型调用的数据流向是两回事。使用什么模型、接入哪些服务,仍然需要根据实际配置判断。
六、数字大脑越聪明,越需要保留证据
AI 能把一段话整理得非常顺畅。
但顺畅,并不能证明它正确。
对艺术金融、文化数字资产、鉴证溯源这类工作来说,来源尤其重要。
某个平台宣传自己取得了某项资质,知识库就应当区分:这是平台自己的说法,还是已经检查了相关文件?
某个案例出现过一次交易,也不能直接推导出它已经形成稳定市场。
某份材料提出一个估值数字,更需要知道时间、方法和适用条件。
所以,Alaya 的基本规则包括:保留原件,记录来源,区分事实与分析,标明待核验事项,保留新旧信息之间的冲突。
AI 的概括不能替代原文,生成的结论也不能凭借漂亮的表达自动获得可信度。
一个可靠的数字大脑,既能帮助你找到答案,也能提醒你:这里还没有足够的证据。
七、先从一个真实问题开始
建立自己的数字大脑,不必先整理电脑里所有文件。
可以先选择一个正在做的事情:
- 一门课程。
- 一项研究。
- 一个产品。
- 一次重要的职业决定。
把相关资料放进去,保存来源,整理几个知识条目,记录当前判断和下一步。
然后让 AI 帮你完成一次实际工作。
完成以后,再检查:哪些理解值得留下,哪些成果以后还会使用,哪些问题需要继续追踪。
如此往复,数字大脑才会开始生长。
我已经把 AI奥杰·Alaya 知识中枢 Skill 发布到 GitHub。它提供七层知识库初始化工具,以及资料入库、溯源、知识更新、成果生产和项目接续规则。
它是一个可以动手使用的起点。真正让它成为”你的大脑”的,是你持续投入的材料、问题与判断。
当答案越来越容易获得,我们更需要认真对待自己的理解。
让今天的思考,成为明天可以接着使用的基础。